
1. Einleitung
Zustandsänderungen von Diensten im Monitoring können irreführend sein, wenn der dazugehörige Host inaktiv oder nicht erreichbar ist. Aus diesem Grund sollte der Zustand des Hosts vor den Zuständen der Dienste bekannt sein, und ein Zustand DOWN des Hosts sollte (dann irrelevante) Benachrichtigungen über Zustände von Diensten unterdrücken. Überwacht man beispielsweise einen Host auch mit aktiven Checks, würde die Benachrichtigung über einen nicht erreichbaren HTTP-Server womöglich auf die falsche Fährte schicken.
Leider ist in einer modernen IT-Umgebung nicht jeder Host direkt vom Checkmk-Server aus erreichbar. Checkmk bietet auch für diese Hosts eine Reihe von Möglichkeiten, ihren Zustand sinnvoll zu bestimmen. Dieser Artikel erklärt sie und ordnet sie ein.
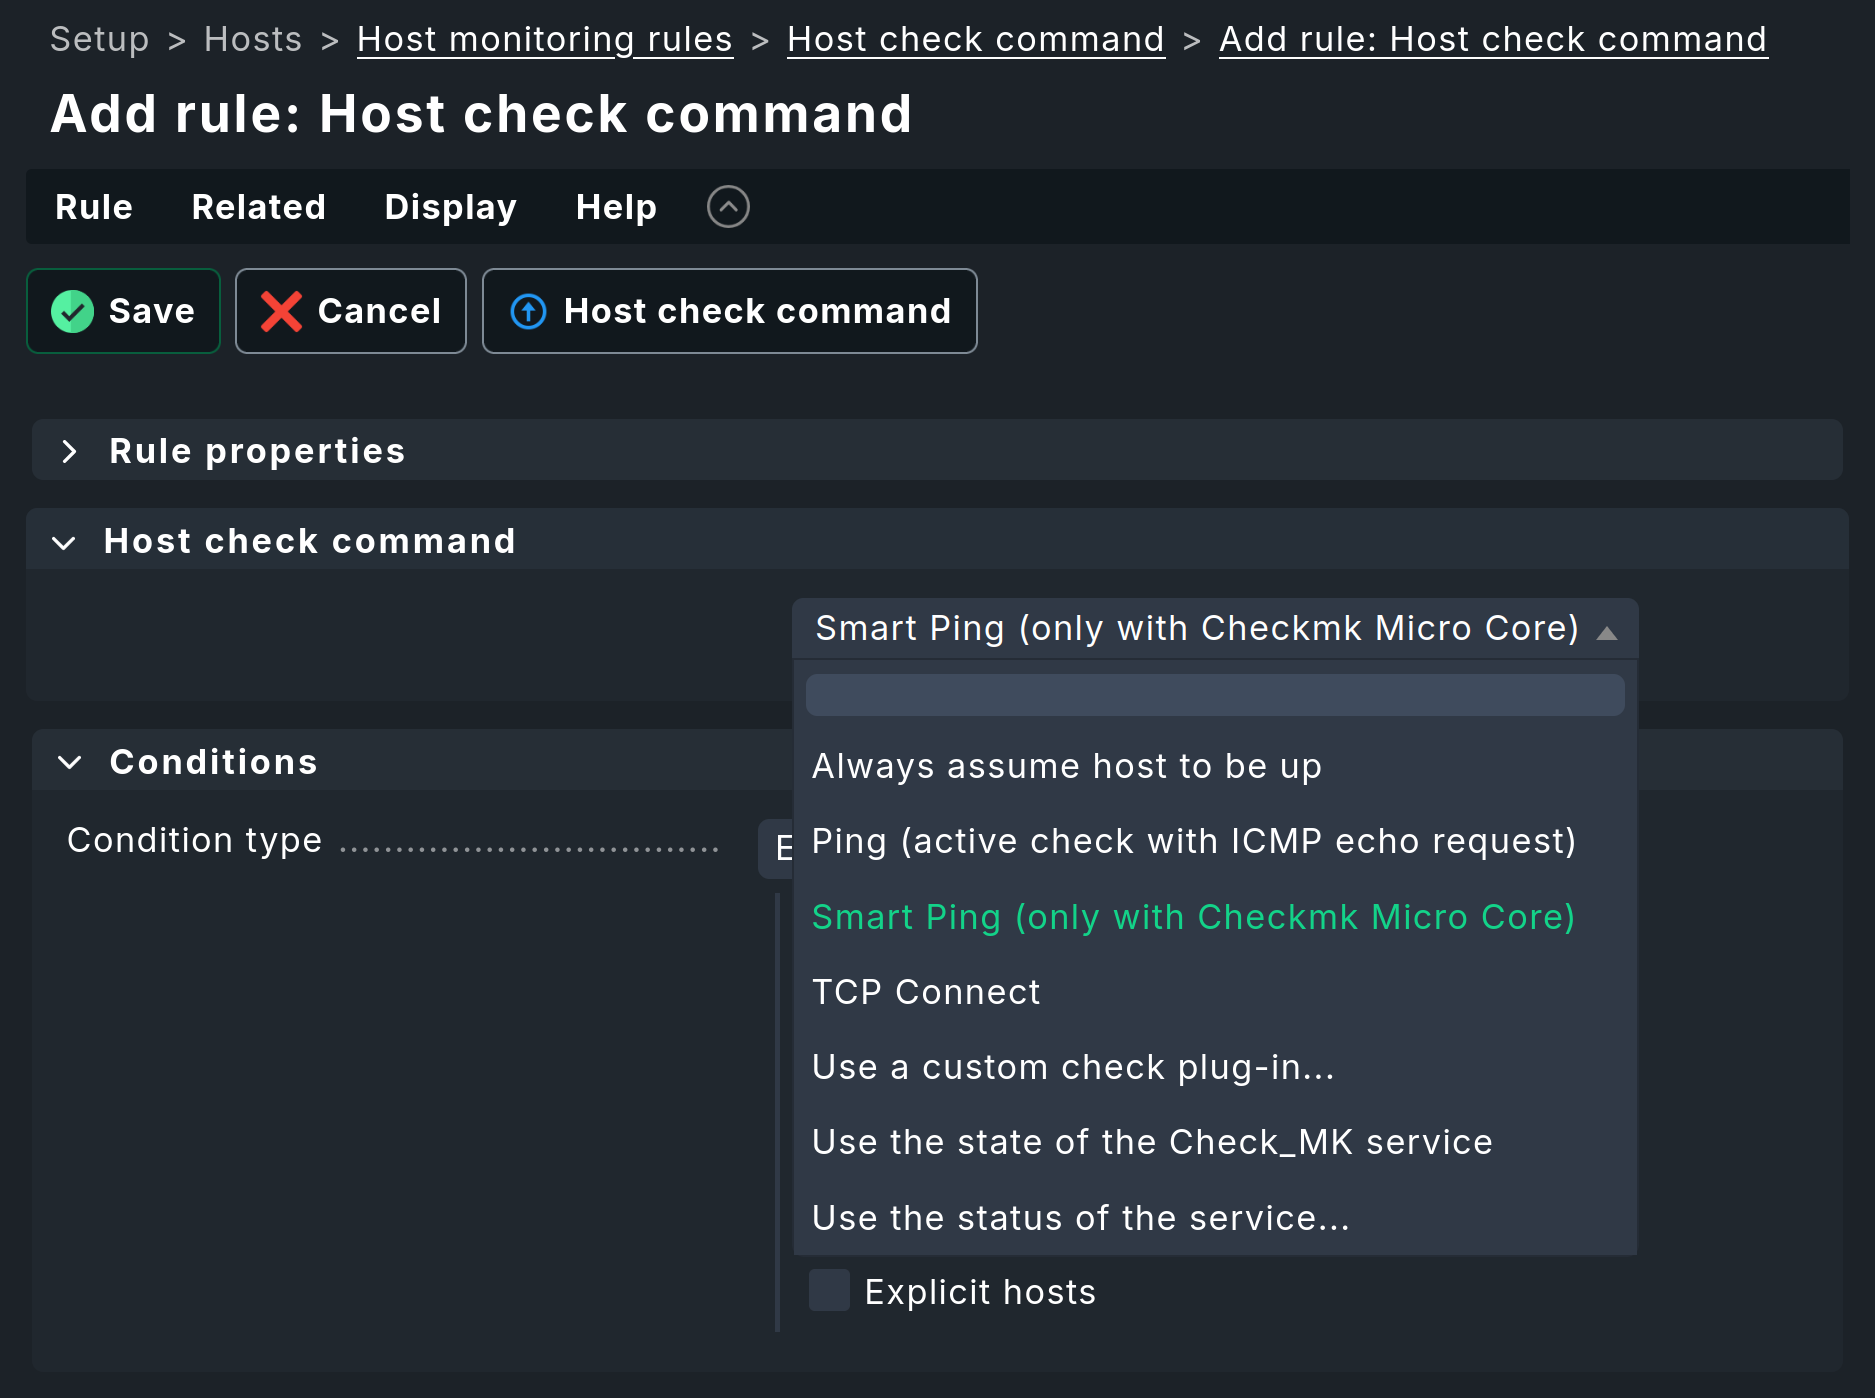
Hier vorgestellte Einstellungen betreffen — wenn nicht abweichend beschrieben — die Regel Setup > Hosts > Host monitoring rules > Host check command.
2. Arten von Host-Checks
Checkmk bietet zwei Arten von Check per Ping und die Möglichkeit des Mappings beliebiger Services auf Host-Zustände. Daneben ist es möglich, beliebige Programme auszuführen, um Zustände von Hosts festzulegen.
2.1. Ping
Hosts, die mit IP-Adresse konfiguriert sind, werden regulär per Ping überprüft. Das Verfahren ist relativ simpel und erfordert geringe Ressourcen: Zur Prüfung, ob ein Host UP ist, werden einige ICMP-Pakete verschickt. Die Hosts beantworten die Pakete mit ICMP-Echo-Replies, welche Checkmk empfängt.
Für die Umsetzung eines Pings existieren in Checkmk zwei Implementierungen:
Klassischer Ping
 Der Standardweg bei Checkmk Community und optional bei den kommerziellen Editionen
ist die Prüfung über einen separaten Subprozess.
Sie kann über die Einstellung Ping (active check with ICMP echo request) aktiviert werden.
Für jeden Host-Check wird dann ein Prozess
check_icmp gestartet.
Dies entspricht einem aktiven Check, der vom Monitoring-Kern disponiert werden muss.
Der Prozess sendet einige Pakete und wartet auf Antwort.
Bleibt die Antwort aus, wird ein von Null verschiedener Exit Code zurückgegeben, was den Host als DOWN kennzeichnet.
Das Warten insbesondere auf ausstehende Pakete im Falle der Nicht-Erreichbarkeit bindet durchaus Ressourcen. Daher kann es bei Checkmk Community in Kombination mit Hosts, die mit dem regulären Checkmk-Agenten oder mit dem Agenten via SSH überwacht werden, sinnvoll sein, stattdessen den Zustand des Dienstes Check_MK heranzuziehen.
Smart Ping
 Smart Ping ist ein Feature des Checkmk Micro Core (CMC) und somit den kommerziellen Editionen vorbehalten.
Der CMC
führt Host-Checks standardmäßig mit einem Verfahren namens Smart Ping aus.
Smart Ping basiert auf einer internen Komponente namens icmpsender, die ihre eigene Ping-Implementierung verwendet.
Da Checkmk mit CMC nicht auf ein externes gestartetes Programm angewiesen ist, muss nicht für jede Prüfung per Ping ein neuer Prozess gestartet werden.
Das Standardverhalten von icmpsender unterscheidet sich deutlich vom Verhalten eines klassischen Ping.
Anstelle mehrerer Pakete in schneller Folge, auf die gewartet wird, sendet icmpsender nur ein ICMP-Paket pro Host alle sechs Sekunden (das Intervall ist mit dem Regelsatz Normal check interval for host checks konfigurierbar).
Dieses Verhalten reduziert Ressourcennutzung und Datenverkehr deutlich.
Für den Empfang ist die CMC-Komponente icmpreceiver zuständig.
Sie entscheidet anhand eingehender Antworten (Echo Replies), ob ein Host UP oder DOWN ist.
Kommt ein Paket an, gilt der Host als UP.
Wurde länger als 15 Sekunden kein Paket von einem Host empfangen, wird dieser Host als DOWN markiert.
Das Timeout können Sie mit dem Regelsatz Settings for host checks via Smart PING ändern — die erwähnten 15 Sekunden ergeben sich aus zweieinhalb Check-Intervallen zu je sechs Sekunden.
Die Komponente icmpreceiver wertet auch eingehende TCP-Pakete mit den Flags SYN (synchronization) und RST (reset, Zurücksetzen einer Verbindung) aus.
Wenn sie solche Pakete empfängt, wird der betreffende Host als UP betrachtet.
 |
Der |
Metriken für Ping
Eine Besonderheit klassischer Checks über ICMP mit der Einstellung Ping (active check with ICMP echo request) ist, dass sie in einer dem Host zugeordneten Metrik resultiert, die Paketverlust und Zeitdauer des Roundtrips abbildet. Das Vorhandensein dieser Daten kann in einigen Fällen zusätzliche wertvolle Einblicke in die Qualität einer Netzwerkanbindung liefern.
Da Smart Ping zur Reduzierung des Overheads keine Sequence Number auswertet, kann mit dieser Methode keine Messung der Laufzeit eines ICMP-Requests und keine Bestimmung verlorener Pakete stattfinden. Falls Sie auf diese Daten angewiesen sind, aktivieren Sie für betreffende Hosts Ping (active check with ICMP echo request) oder konfigurieren Sie zusätzlich zu Smart Ping den aktiven Check Check hosts with ping (ICMP echo request).
2.2. Zustand des Dienstes Check_MK
Mit der Einstellung Use the state of the Check_MK service legen Sie fest, dass ein Host UP sein soll, wenn Check_MK auf OK ist und DOWN in allen anderen Fällen. Diese Einstellung sollten Sie verwenden, wenn überwachte Hosts in einem Netzwerk mit Zero Inbound Traffic liegen und Monitoring-Daten per Push-Modus zum Checkmk-Server schicken.
Bei Nutzung von Checkmk Community kann diese Einstellung die Leistung durch ausbleibende Host-Checks vor Versand von Notifications verbessern, allerdings steigt möglicherweise die Zahl von falsch positiven Host-Notifications etwas.
2.3. Zustand eines anderen Dienstes
Über die Einstellung Use the status of the service… können Sie einen beliebigen Dienst definieren, der den Host-Zustand bestimmt. Wenn ein überwachter Host per SSH vom Monitoring-Server aus erreichbar ist, können Sie beispielsweise Setup > Services > Other services > Check SSH service verwenden, um einen Handshake mit dem SSH-Server zu testen. Schlägt dieser fehl, mag ein Host zwar theoretisch erreichbar sein, erfordert aber in jedem Fall Aufmerksamkeit, bevor andere Probleme angegangen werden.
2.4. Verbindung zu einem TCP-Port
Eine generische Variante der zuletzt vorgestellten Herangehensweise Zustand eines anderen Dienstes stellt TCP connect dar. Hier wird nur die Möglichkeit einer TCP-Verbindung selbst geprüft. Handshakes oder ähnliches bleiben unberücksichtigt. Beachten Sie, dass im Falle von Paketverlust und ähnlichen Netzwerkproblemen ähnliche Performance-Einbußen drohen wie beim regulären Ping-Check.
2.5. Ein Befehl bestimmt den Zustand
Weit reichende Freiheit haben Sie mit Use a custom check plug-in.
Hier können Sie einen beliebigen Befehl angeben und ein Exit Code von genau 2 wird als DOWN gewertet.
Befehle können Monitoring-Plugins sein (bei diesen bedeutet 2 immer CRIT) oder einfache Shell-Befehle.
Wenn Sie beispielsweise eine Agentenausgabe als Datei auf irgendeine kreative Art und Weise zum Monitoring-Server bringen und dort auslesen, kann die Prüfung auf Vorhandensein oder eine minimale Dateigröße mittels test Rückschlüsse auf den Host-Zustand geben.
Um alle von Null verschiedenen Rückgabewerte als DOWN zu werten, ist ein klein wenig Kreativität erforderlich:
2.6. Betrachte einen Host immer als UP
Die Einstellmöglichkeit Always assume host to be up ist dann sinnvoll, wenn ein bestimmter Host im Monitoring gar nicht „real“ ist, sondern lediglich als Container für eine Ansammlung von Diensten dienen soll. Das kann beispielsweise im Cloud- oder Cluster-Monitoring der Fall sein, wo Daten per Piggyback eingeholt werden und solche Hosts dynamisch erzeugt werden. Diese Einstellung ist daher Standard, wenn ein Host explizit ohne IP-Adresse konfiguriert ist (No IP).
3. Erneute Host-Checks bei Service-Problemen
Host-Checks dienen — wie eingangs erwähnt — nicht nur der Kontrolle, ob ein Host UP oder DOWN ist. Ihr zweiter Zweck ist, vor dem Versand von Benachrichtigungen zu aktiven Checks zu ermitteln, ob nicht der Host-Zustand Ursache für den Service-Zustand ist. Erst danach wird die passende Benachrichtigung ausgelöst.
Performance und Zuverlässigkeit unterscheiden sich dabei zwischen aktiv ausgelösten Host-Checks und Host-Checks per Smart Ping.
3.1. Aktiver Host-Check
Das Standardverhalten ist, nach einem fehlgeschlagenen aktiven Check einen Host-Check auszulösen und dann zu entscheiden, ob über Host- oder Service-Zustand benachrichtigt wird.
Das Verfahren unterscheidet sich hierbei im Detail zwischen Checkmk Community und den kommerziellen Editionen (bei Verwendung des Checkmk Micro Core, aka CMC):
In Checkmk Community werden Resultate von Host-Checks für einige Sekunden zwischengespeichert. Diese Zwischenspeicherung soll die erneute Ausführung eines Host-Checks verhindern, wenn die letzte erst einige Sekunden zurückliegt. Sie kann jedoch zu fehlerhaften Benachrichtigungen führen, wenn der Host beim Host-Check vor einigen Sekunden noch UP war, nun aber CRIT eines HTTP-Checks seine Ursache in danach aufgetretenen Netzwerkproblemen hat. Ist das zwischengespeicherte Resultat veraltet, wird unmittelbar ein neuer Host-Check durchgeführt, was Ressourcen bindet (Erstellung eines Prozesses).
Die kommerziellen Editionen starten sofort einen Prozess. Da hierfür ein Active Check Helper verwendet wird, ist der Ressourcenbedarf geringer als bei Checkmk Community.
3.2. Passiver Host-Check per Smart Ping
Ist Smart Ping konfiguriert, kann der Monitoring-Kern sich passiv verhalten und muss keinen Check aktiv auslösen.
Der icmpsender sendet kontinuierlich im Intervall von sechs Sekunden und der icmpreceiver lauscht dauerhaft auf ICMP-Echo-Replies und TCP-RST-Pakete.
Ist der Host tatsächlich nicht erreichbar, wartet der CMC die konfigurierte Zeitspanne ab (regulär 2,5 Intervalle, also 15 Sekunden) und verschickt dann eine Benachrichtigung zum Host-Zustand DOWN. Hier eben mit 15 Sekunden Verzögerung, aber ohne, dass ein neuer Prozess gestartet werden musste.
Gehen jedoch Lebenszeichen des Hosts ein, kann sofort zum Service benachrichtigt werden. Ein Beispiel aus der Praxis: Sie haben einen aktiven Check für SSL-Zertifikate konfiguriert. Schlägt dieser fehl, weil der Webserver überlastet oder nicht aktiv ist, dann geht einige Millisekunden nach Start des aktiven Checks ein TCP-RST-Paket ein. Dieses Paket signalisiert Checkmk, dass der Host zwar eine Verbindung auf Port 443 verweigert hat, dies aber nur kann, weil er UP ist. In diesem Fall kann sofort zum Service-Zustand benachrichtigt werden.
Das gleiche Prinzip wird bei der Benachrichtigung zu Netzwerkausfällen angewandt, wenn Parent-Hosts definiert sind: Gehen Lebenszeichen eines Switches ein, kann zu Hosts benachrichtigt werden, die über diesen Switch erreichbar sind.
Resultierende Vorteile
Durch dieses Verfahren ergibt sich eine Reihe von Vorteilen von Smart Ping verglichen mit aktiven Host-Checks:
Nahezu vernachlässigbare CPU-Last durch Host-Checks: Es können selbst ohne besonders leistungsfähige Hardware Zigtausende von Hosts überwacht werden.
Kein Ausbremsen des Monitorings durch blockierende aktive Host-Checks, falls Hosts DOWN sind.
Keine Fehlalarme zu Services bei nicht aktuellem zwischengespeicherten Host-Zustand.
4. Troubleshooting
Wie bei Service-Checks können auch bei Host-Checks Feinheiten Ihrer Systemumgebung oder Firewall-Konfiguration Anpassungen erforderlich machen.
4.1. Caching-Intervall bei Checkmk Community
Die Zwischenspeicherung des letzten Host-Checks bei Checkmk Community kann zu falschen Benachrichtigungen zu Service-Problemen führen, wenn eigentlich zu Host-Problemen benachrichtigt werden müsste. Die Dauer der Zwischenspeicherung können Sie bei Checkmk Community nur global über die Einstellungen des Monitoring-Kerns anpassen. In welchen Konfigurationsdateien Änderungen vorzunehmen sind, zeigt der Artikel zum Tuning des Monitoring-Kerns.
Beachten Sie, dass die Reduzierung auf Null (sofortige erneute Ausführung des Host-Checks) nur vorgenommen werden sollte, wenn die Zahl aktiver Checks in Ihrem Monitoring klein ist.
4.2. Firewall-Probleme bei Smart Ping
Firewall sendet selbst TCP-RST-Pakete
Es gibt Firewalls, die TCP-Verbindungspakete an nicht erreichbare Hosts nicht verwerfen, sondern mit einem TCP-RST-Paket beantworten. In solch einem Fall darf die Firewall als Absender dieser Pakete nicht sich selbst eintragen, sondern muss die IP-Adresse des Ziel-Hosts angeben. Smart Ping wird dieses Paket als Lebenszeichen werten und somit zu Unrecht annehmen, dass der Ziel-Host erreichbar ist.
In dieser Situation haben Sie die Möglichkeit, mit Global settings > Monitoring core > Tuning of Smart PING die Option Ignore TCP RST packets when determining host state zu aktivieren.
Umgebungen ohne ICMP
Ist in Ihrer Umgebung ICMP vollständig blockiert, werden Sie mit Hosts konfrontiert sein, die schnell zwischen UP und DOWN hin- und her wechseln (flapping). In diesem Fall sorgt TCP-Verkehr bei der Agentenabfrage oder der Durchführung der aktiven Checks zu UP, der kurze Timeout von 15 Sekunden aber schnell wieder zu DOWN. Wählen Sie in solchen Fällen nicht Smart Ping, sondern andere in diesem Artikel beschriebene Methoden zur Bestimmung des Host-Zustandes.